Domain pizsa.de kaufen?
Wir ziehen mit dem Projekt
pizsa.de um.
Sind Sie am Kauf der Domain
pizsa.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain pizsa.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
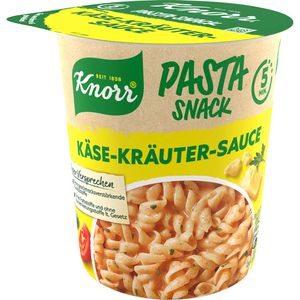
Knorr Fertiggericht Pasta Snack, Käse-Kräuter-Sauce, je 59g, 8 StückNudeln in cremiger Käse-Kräuter-Sauce Schnell und unkompliziert in nur 5 Minuten zubereitet Ohne Geschmacksverstärker, Konservierungs- und Farbstoffe Idealer Snack im Büro oder für Zuhause Merkmale: Sorte: Nudelgericht Zubereitungsart: instant Ernährungsform: vegetarisch Lebensmittelinformationen: Besonderheit: vegetarisch Inhalt: 472g, Zutaten: 61% Teigwaren (HARTWEIZENGRIESS, EIWEISS), Stärke, 5,5% SAHNEPULVER, Sonnenblumenöl, Tomatenmarkpulver, Schmelzkäsepulver (Mozzarella-KÄSE, KÄSE, Molkeprodukt (MILCH)), Glukosesirup, Aromen (mit WEIZEN, GERSTE), jodiertes Speisesalz, MILCHZUCKER, MILCHEIWEISS, Petersilie, Basilikum, Zwiebeln, Pfeffer, Curcuma, Petersilienwurzel, Kochsalzersatz, Hefeextrakt. Enthält: HARTWEIZENGRIESS, EIWEISS, SAHNEPULVER, KÄSE, MILCH, WEIZEN, GERSTE, MILCHZUCKER, MILCHEIWEISS Kann enthalten: SOJA, SENF, SELLERIE Aufbewahrungshinweise: Bitte trocken lagern und vor Wärme schützen. Lebensmittelunternehmer, in dessen Namen das Produkt vermarktet wird: Unilever Deutschland, Postfach 570 237, 22771 Hamburg11,92 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
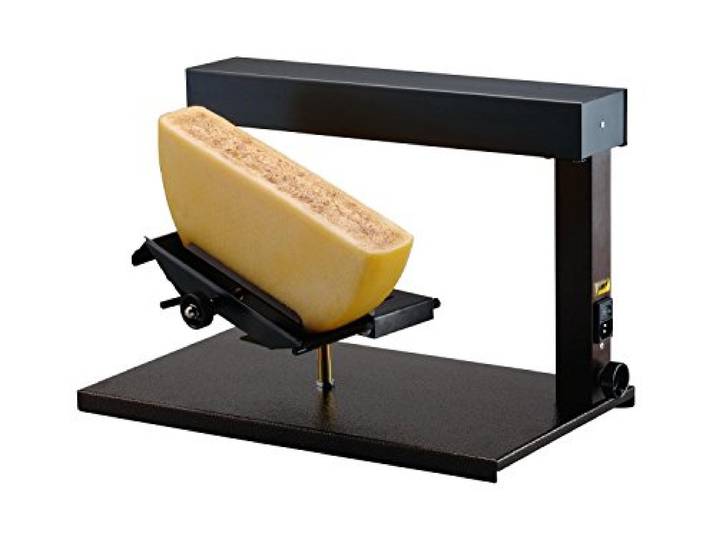
TTM Ambiance Raclette-Ofen, Klassisches Raclette für einen halben Käse, Kippbarer Kombi–Käsehalter für runden und eckigen Käse, 48x27x32 cm, 1000 WTTM Ambiance Raclette-Ofen, Klassisches Raclette für einen halben Käse, Kippbarer Kombi–Käsehalter für runden und eckigen Käse, 48x27x32 cm, 1000 W. TTM Raclette Cheese Melter Ambiance for 1/2 round of cheese Farbe:Schwarz277,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **


Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
4er-Pack Landgarten Bio Mandeln - Tomate-KräuterMediterran gewürzt, mit feinem Biss Mandeln können mehr, als nur pur verzehrt zu werden. In dieser Variante zeigen sie sich von ihrer aromatischen Seite: geröstet und veredelt mit einer fein abgestimmten Mischung aus Tomate und mediterranen Kräutern. Der erste Eindruck ist würzig und leicht fruchtig, getragen von der natürlichen Süße der Mandel. Dazu kommt eine angenehme Kräuternote, die an sonnengereifte Zutaten erinnert und dem Snack eine warme, ausgewogene Tiefe verleiht. Der Biss bleibt knackig, der Geschmack vielschichtig und dennoch klar. Jeder Griff bringt ein Stück mediterranes Gefühl – unkompliziert, aber mit spürbarem Anspruch.9,89 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Knorr Fertiggericht Pasta Snack, Käse-Kräuter-Sauce, je 59g, 8 StückNudeln in cremiger Käse-Kräuter-Sauce Schnell und unkompliziert in nur 5 Minuten zubereitet Ohne Geschmacksverstärker, Konservierungs- und Farbstoffe Idealer Snack im Büro oder für Zuhause Merkmale: Sorte: Nudelgericht Zubereitungsart: instant Ernährungsform: vegetarisch Lebensmittelinformationen: Besonderheit: vegetarisch Inhalt: 472g, Zutaten: 61% Teigwaren (HARTWEIZENGRIESS, EIWEISS), Stärke, 5,5% SAHNEPULVER, Sonnenblumenöl, Tomatenmarkpulver, Schmelzkäsepulver (Mozzarella-KÄSE, KÄSE, Molkeprodukt (MILCH)), Glukosesirup, Aromen (mit WEIZEN, GERSTE), jodiertes Speisesalz, MILCHZUCKER, MILCHEIWEISS, Petersilie, Basilikum, Zwiebeln, Pfeffer, Curcuma, Petersilienwurzel, Kochsalzersatz, Hefeextrakt. Enthält: HARTWEIZENGRIESS, EIWEISS, SAHNEPULVER, KÄSE, MILCH, WEIZEN, GERSTE, MILCHZUCKER, MILCHEIWEISS Kann enthalten: SOJA, SENF, SELLERIE Aufbewahrungshinweise: Bitte trocken lagern und vor Wärme schützen. Lebensmittelunternehmer, in dessen Namen das Produkt vermarktet wird: Unilever Deutschland, Postfach 570 237, 22771 Hamburg11,92 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
TTM Ambiance Raclette-Ofen, Klassisches Raclette für einen halben Käse, Kippbarer Kombi–Käsehalter für runden und eckigen Käse, 48x27x32 cm, 1000 WTTM Ambiance Raclette-Ofen, Klassisches Raclette für einen halben Käse, Kippbarer Kombi–Käsehalter für runden und eckigen Käse, 48x27x32 cm, 1000 W. TTM Raclette Cheese Melter Ambiance for 1/2 round of cheese Farbe:Schwarz277,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kinderkostüm "Tomate"Kinderkostüm Tomate – das perfekte Kostüm für freche Früchtchen!Besonderheiten: Kostüm und Mütze mit grünen Blätter-AttrappenLieferumfang: Kostüm, MützeDetails: Kostüm hinten mit Klettverschluss, unten mit Gummizug, ärmellosFarbe: rotStoffart: formstabiles Polyester-GewebeMaterial: 100 % PolyesterZwar ist die Tomate biologisch gesehen Obst, Ihr junges Gemüse sieht in diesem tollen Tomaten-Kostüm aber trotzdem zum Anbeißen aus! In knalligem Rot sticht Ihre kleine Tomate so richtig heraus und bringt Farbe in den Faschings-Garten. Auch für den Straßenkarneval ist Ihr Kind mit diesem Tomatenkostüm bestens gerüstet, denn unter dem Kostüm ist noch genug Platz für warme Kleidung und eine Jacke. Gemüse- und Obstkostüme sind übrigens auch super als Familienkostüm geeignet – da kommt Schwung ins Beet!19,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Wolff, Kerstin: Tomate, Fahrrad, GuillotineTomate, Fahrrad, Guillotine , Eine kurze Frauengeschichte in 30 Objekten , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20230223, Produktform: Leinen, Autoren: Wolff, Kerstin, Illustrator: Prenzel, Tatjana, Seitenzahl/Blattzahl: 192, Abbildungen: 65 farbige Abbildungen, Keyword: Diskriminierung; Emanzipation; Feminismus; Feminismus-Buch; Frauen; Frauen die die Welt bewegten; Frauenbewegung; Frauengeschichte; Frauenrechte; Gender; Geschenk Mädchen; Geschenkbuch; Geschichtsbuch; Geschichtswissenschaften; Geschlechtergerechtigkeit; Geschlechterrollen; Gesellschaft; Gleichberechtigung; Gleichstellung; Herstory; Identität; Patriachat; Porträts Frauen; Rollenklischees; Sachbuch; Sexismus; Unsichtbare Frauen; Weltgeschichte; berühmte Frauen; feministisch, Fachschema: Feminismus~Frauenbewegung / Feminismus, Fachkategorie: Sozial- und Kulturgeschichte, Interesse Alter: für Frauen und/oder Mädchen, Thema: Entdecken, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Feminismus und feministische Theorie, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Knesebeck Von Dem GmbH, Verlag: Knesebeck Von Dem GmbH, Verlag: Knesebeck, Länge: 215, Breite: 176, Höhe: 21, Gewicht: 572, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0070, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,20,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.